Text & Schreiben
Das Leben ist ermüdend, aber die Zukunft "wird besser sein" Pokkoa KI x I Ging Einsichten Entdeckung
Das Leben ist ermüdend, aber die Zukunft "wird besser sein" Pokkoa KI x I Ging Einsichten EntdeckungEntfesseln Sie die Macht von KI-I-Ging für Erkenntnisentdeckung und detaillierte Führung
0
Konvertieren Sie Ihre Vokale mit unseren lizenzfreien Stimmen, trainieren Sie Ihre eigenen Stimmen, erstellen Sie urheberrechtsfreie Cover-Vokale und vieles mehr.
489.79 K
KI-Mathematik-GPT-Löser, unterstützt durch GPT-4o | Kostenlos online | Math-Bot
KI-Mathematik-GPT-Löser, unterstützt durch GPT-4o | Kostenlos online | Math-BotSchließen Sie mathematische Lösungen sofort mit unserem kostenlosen AI-basierten Math-Löser auf. Erhalten Sie schrittweise Anleitung zu Gleichungen, Textaufgaben und mehr, jederzeit, überall mit GPT-4o-Technologie.
0
Ai5 ist Ihr zweimal wöchentliches E-Mail-Update, das die wichtigsten Ereignisse im Bereich der generativen KI zusammenfasst. Bleiben Sie informiert, werden Sie schlauer und lassen Sie sich von Ai5 unterhalten.
0
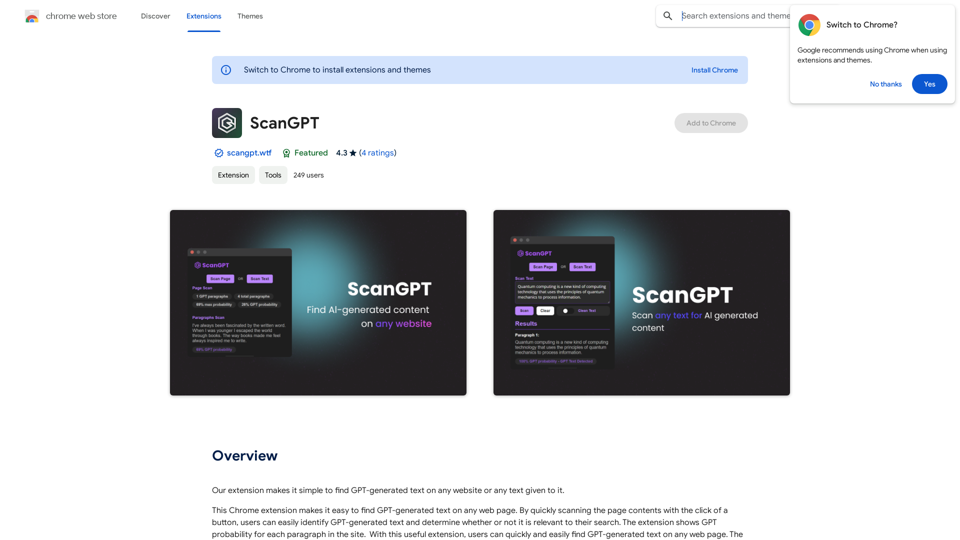
Unsere Erweiterung macht es einfach, GPT-generierten Text auf jeder Website oder darin bereitgestellten Text zu finden.
193.90 M
IntegraBot - Agenten mit fortschrittlicher KI und Automatisierungen
IntegraBot - Agenten mit fortschrittlicher KI und AutomatisierungenErstellen Sie einen Chatbot-KI basierend auf Ihrer Wissensbasis und fügen Sie ihn Ihrem Website hinzu oder interagieren Sie mit ihm über unsere API.
357
Meisterhaft Mathe meistern! Schritt-für-Schritt-Lösungen für Arithmetik, Algebra, Trigonometrie und Geometrie. Sofortiges Snap & Fragen, reiche Materialien, vielfältige Übung. Vereinfachen Sie Mathe mit Math Sniper – wo Präzision auf Einfachheit trifft!
0
Die umfassende Audio-AI-Plattform. Die ultimative Lösung für Audio-Transkription, Sprache-zu-Text, Audio-Stift, Text-zu-Sprache, Videobearbeitung, Live-Stream-Untertitelung
Die umfassende Audio-AI-Plattform. Die ultimative Lösung für Audio-Transkription, Sprache-zu-Text, Audio-Stift, Text-zu-Sprache, Videobearbeitung, Live-Stream-UntertitelungDie All-in-One-Audio-KI-Plattform. Die ultimative Lösung für Audiotranskription, Speech-to-Text, Audiostift, Text-to-Speech, Videoüberspielung und Live-Stream-Untertitel
0
Stabile Diffusion 3 Kostenlosen Online-Zugriff - Unterstützt durch SD3-API
Stabile Diffusion 3 Kostenlosen Online-Zugriff - Unterstützt durch SD3-APIEntdecken Sie Stable Diffusion 3, das fortschrittliche Text-zu-Bild-Modell von Stability AI. Erfahren Sie mehr über das Stable-Diffusion-3-Veröffentlichungsdatum, Stable-Diffusion-3-Download, Stable-Diffusion-3-API und Zugriff auf Stable-Diffusion-3-kostenlos online.
105.22 K
ChatTTS ist ein Sprachgenerierungsmodell auf GitHub bei 2noise/chattts. Chat TTS ist speziell für konversationelle Szenarien konzipiert. Es eignet sich ideal für Anwendungen wie Dialogaufgaben für große Sprachmodell-Assistenten sowie konversationelle Audio- und Videoeinleitungen. Das Modell unterstützt sowohl Chinesisch als auch Englisch und zeigt eine hohe Qualität und Natürlichkeit bei der Sprachsynthese. Dieses Leistungsniveau wird durch das Training mit etwa 100.000 Stunden an chinesischen und englischen Daten erreicht. Darüber hinaus plant das Projektteam, ein grundlegendes Modell mit 40.000 Stunden an Daten offen zu legen, das der akademischen und Entwicklergemeinschaft bei weiteren Forschungen und Entwicklungen helfen wird.
23.26 K